
Tekunda Team
Tekunda Team
Kort antwoord: AI-agents falen in productie meestal door het systeem rond het model, niet door het model zelf. De gebruikelijke oorzaken zijn een scope die op de demo is afgestemd, geen echte integratie met de bronsystemen, generieke context, stille fouten die niemand kan traceren, geen feedbackloop, en niemand die de uitkomst of de kosten bezit. We liepen tegen de meeste van deze problemen aan bij het bouwen van onze eigen outbound-prospectingagent. Hieronder lees je hoe je die van jou diagnosticeert, en wat we veranderd hebben om de onze stand te laten houden.
Het faalpercentage is niet anekdotisch. Gartner voorspelt dat meer dan 40% van de agentic-AI-projecten eind 2027 is geannuleerd, met als redenen oplopende kosten, onduidelijke businesswaarde en onvoldoende risicobeheersing. S&P Global Market Intelligence zag dat 42% van de bedrijven in 2025 de meeste van hun AI-initiatieven staakte, tegenover 17% een jaar eerder, en dat organisaties 46% van de proof-of-concepts schrapten voordat ze in productie gingen. Het NANDA-onderzoek van MIT legt het kernprobleem bij integratie en leren, niet bij modelkwaliteit. We behandelen het bredere plaatje in AI-agents in 2026: wat werkt echt en waarom de meeste initiatieven vastliepen.
In onze ervaring vallen die cijfers uiteen in zes faalpatronen:
Koppel het symptoom aan de oorzaak voordat je het model of de prompt verandert:
Bij Tekunda wilden we meer dan een demo in een vergaderzaal: een agent die outbound prospecting over LinkedIn en Salesforce automatiseert, redeneert over echte context en calls boekt. Elke stap hieronder bestaat omdat een van de faalpatronen hierboven ons eerst trof.
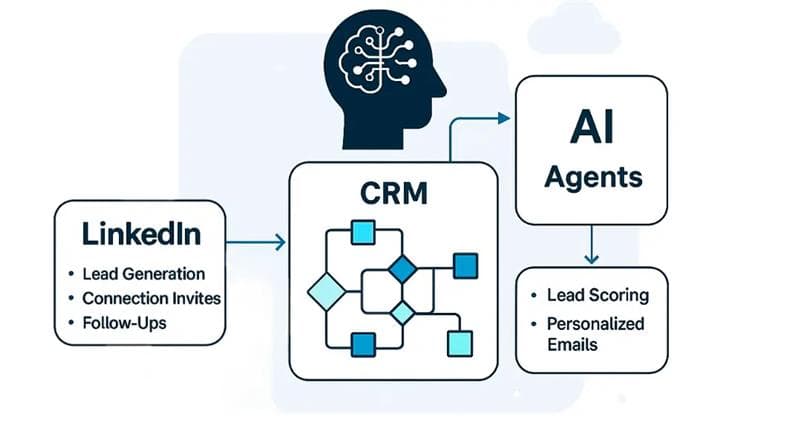
De agent bezit één workflow: van een LinkedIn-leadlijst tot een geboekte call. Een zoekresultaat of Sales Navigator-lijst gaat naar Linked Helper, dat connectieverzoeken automatiseert binnen LinkedIn's wekelijkse limieten, bedank-follow-ups en de sync naar Salesforce. Zodra een nieuwe connectie in het CRM landt, neemt de agent het over.
De agent redeneert over historische leaddata, inclusief conversiegeschiedenis, succescriteria en segmentkenmerken, als retrievalcontext. We testten zowel vector stores als PostgreSQL-gebaseerde retrieval en kozen op basis van prestaties en kosten, met chunking en retrieval afgestemd op leadkwalificatie in plaats van generieke zoekopdrachten.
De logica draait in Langflow, ondersteund door eigen Python-flows en onze interne MCP-servers die API-calls, enrichment en promptuitvoering afhandelen. De flow is stateless en opgedeeld in kleine micro-flows die we hergebruiken over campagnes heen. Wanneer één agent er meerdere worden, wordt de overdracht het volgende breekpunt, daarom schreven we op wat agent-naar-agent-overdrachten in productie laat werken.
Voor kwalificerende leads stelt de agent een gepersonaliseerde e-mail op uit bedrijfsinformatie, rolsignalen en recente activiteit, met een call-to-action gemodelleerd op wat werkte bij eerdere wins. Elke e-mail wordt teruggeschreven naar Salesforce, zodat sales dezelfde record ziet waarop de agent handelde.
We traceren elke agentoutput in Langfuse en interne dashboards, met gestructureerde foutafhandeling, prompt diffing en outcome-analyse die in de flow zijn ingebouwd. Conversiesignalen voeden terug in de ranking- en promptlagen, en elke week verfijnen we prompts, trainen we embeddings opnieuw en stellen we scoring bij. Die loop is het verschil tussen een agent die afbreekt en een agent die verbetert.
Het resultaat: geen handmatige overdracht van uitnodiging tot geboekte call. LinkedIn beperkt de bovenkant van de funnel, maar enrichment, scoring en e-mailgeneratie daarachter schalen mee met de pipeline.
Als je agent binnen Salesforce leeft, bepaal dan vroeg of je configureert of bouwt: onze gids Agentforce versus custom AI-agents loopt die keuze door. En als je een agent zoals deze wilt laten bouwen rond je eigen workflow, bekijk dan hoe wij AI-agents voor productie bouwen of praat met ons team.
Waarom werken mijn AI-agents in testen maar falen ze in productie?
Testen draaien meestal op schone data en één happy path. Productie voegt rommelige records, echte integraties en edge cases toe, en zonder tracing blijven die fouten stil.
Hoeveel AI-agentprojecten falen?
Gartner voorspelt dat meer dan 40% van de agentic-AI-projecten eind 2027 is geannuleerd, en S&P Global zag dat 42% van de bedrijven in 2025 de meeste van hun AI-initiatieven staakte.
Hoe monitor je een AI-agent in productie?
Traceer elke run, inclusief tool-calls en retrievals, en volg promptwijzigingen tegen resultaten. Tools zoals Langfuse in combinatie met interne dashboards maken agentbeslissingen debugbaar.
Moeten we een AI-agent intern bouwen of met een partner?
Het NANDA-onderzoek van MIT rapporteerde dat oplossingen die van gespecialiseerde leveranciers zijn gekocht veel vaker slagen dan interne bouwtrajecten. Bouw intern als de workflow kernactiviteit is en je observability en iteratie kunt bemannen.