
Tekunda Team
Tekunda Team
Kurz gesagt: KI-Agenten scheitern in der Produktion meist wegen des Systems um das Modell herum, nicht wegen des Modells selbst. Die üblichen Ursachen sind ein auf die Demo zugeschnittener Umfang, keine echte Integration mit den führenden Systemen, generischer Kontext, stille Fehler, die niemand nachvollziehen kann, keine Feedbackschleife und niemand, der für Ergebnis oder Kosten verantwortlich ist. Wir sind auf die meisten dieser Fallen gestoßen, als wir unseren eigenen Outbound-Prospecting-Agenten gebaut haben. Im Folgenden zeigen wir, wie Sie Ihren Agenten diagnostizieren, und was wir geändert haben, damit unserer standhält.
Die Fehlerquote ist nicht anekdotisch. Gartner prognostiziert, dass über 40 % der agentenbasierten KI-Projekte bis Ende 2027 eingestellt werden, und nennt steigende Kosten, unklaren Geschäftswert und unzureichende Risikokontrollen als Gründe. S&P Global Market Intelligence fand heraus, dass 42 % der Unternehmen 2025 die meisten ihrer KI-Initiativen aufgaben, gegenüber 17 % im Jahr davor, und dass Unternehmen 46 % der Proofs of Concept vor der Produktion verwarfen. Die NANDA-Forschung des MIT verortet das Kernproblem in Integration und Lernen, nicht in der Modellqualität. Das größere Bild behandeln wir in KI-Agenten 2026: was wirklich funktioniert und warum die meisten Projekte stecken blieben.
Nach unserer Erfahrung zerfallen diese Zahlen in sechs Fehlermodi:
Ordnen Sie das Symptom der Ursache zu, bevor Sie Modell oder Prompt ändern:
Bei Tekunda wollten wir mehr als eine Demo im Besprechungsraum: einen Agenten, der Outbound-Prospecting über LinkedIn und Salesforce automatisiert, über echten Kontext nachdenkt und Calls bucht. Jeder Schritt unten existiert, weil uns einer der obigen Fehlermodi zuerst erwischt hat.
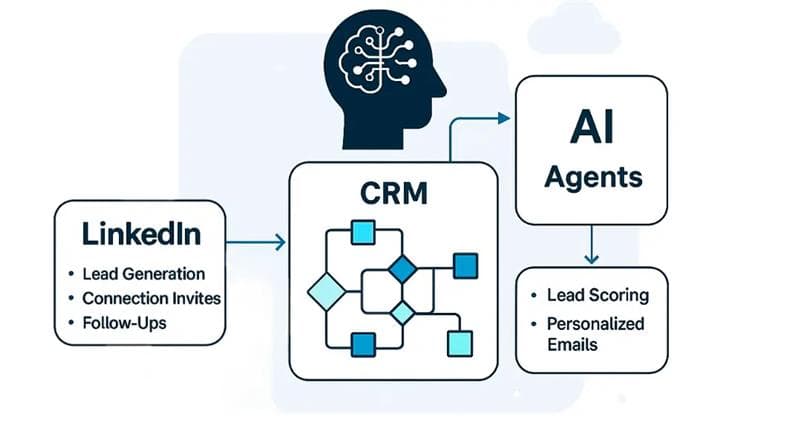
Der Agent besitzt einen einzigen Workflow: von einer LinkedIn-Leadliste zu einem gebuchten Call. Ein Suchergebnis oder eine Sales-Navigator-Liste geht in Linked Helper, das Verbindungsanfragen innerhalb der wöchentlichen LinkedIn-Limits automatisiert, Dankes-Follow-ups versendet und die Synchronisation nach Salesforce übernimmt. Sobald eine neue Verbindung im CRM landet, übernimmt der Agent.
Der Agent denkt über vergangene Lead-Daten nach, einschließlich Konversionshistorie, Erfolgskriterien und Segmentmerkmalen, als Retrieval-Kontext. Wir haben sowohl Vector Stores als auch PostgreSQL-basiertes Retrieval getestet und nach Leistung und Kosten entschieden, mit Chunking und Retrieval, die auf Lead-Qualifizierung statt generischer Suche abgestimmt sind.
Die Logik läuft in Langflow, gestützt von eigenen Python-Flows und unseren internen MCP-Servern, die API-Aufrufe, Enrichment und Prompt-Ausführung übernehmen. Der Flow ist stateless und in kleine Micro-Flows aufgeteilt, die wir über Kampagnen hinweg wiederverwenden. Wenn aus einem Agenten mehrere werden, werden Übergaben zum nächsten Schwachpunkt, deshalb haben wir aufgeschrieben, was Agent-zu-Agent-Übergaben in der Produktion funktionieren lässt.
Für qualifizierende Leads verfasst der Agent eine personalisierte E-Mail aus Unternehmensinformationen, Rollensignalen und aktueller Aktivität, mit einem Call-to-Action, der sich an dem orientiert, was bei früheren Erfolgen funktioniert hat. Jede E-Mail wird zurück nach Salesforce gespielt, damit der Vertrieb denselben Datensatz sieht, auf dem der Agent gehandelt hat.
Wir tracken jede Agenten-Ausgabe in Langfuse und internen Dashboards, mit strukturierter Fehlerbehandlung, Prompt-Diffing und Ergebnisanalyse, die in den Flow eingebaut sind. Konversionssignale fließen zurück in die Ranking- und Prompt-Ebenen, und jede Woche verfeinern wir Prompts, trainieren Embeddings neu und justieren das Scoring. Diese Schleife macht den Unterschied zwischen einem Agenten, der verfällt, und einem, der sich verbessert.
Das Ergebnis: keine manuelle Übergabe von der Einladung bis zum gebuchten Call. LinkedIn begrenzt die Spitze des Funnels, aber Enrichment, Scoring und E-Mail-Generierung dahinter skalieren mit der Pipeline.
Lebt Ihr Agent innerhalb von Salesforce, entscheiden Sie früh, ob Sie konfigurieren oder bauen: unser Leitfaden Agentforce gegen individuelle KI-Agenten führt durch diese Entscheidung. Und wenn Sie einen solchen Agenten rund um Ihren eigenen Workflow gebaut haben möchten, sehen Sie sich an, wie wir KI-Agenten für die Produktion bauen, oder sprechen Sie mit unserem Team.
Warum funktionieren meine KI-Agenten im Test, scheitern aber in der Produktion?
Tests laufen meist mit saubereren Daten und einem einzigen Idealpfad. Die Produktion bringt unordentliche Datensätze, echte Integrationen und Sonderfälle mit sich, und ohne Tracing bleiben diese Fehler still.
Wie viele KI-Agenten-Projekte scheitern?
Gartner prognostiziert, dass über 40 % der agentenbasierten KI-Projekte bis Ende 2027 eingestellt werden, und S&P Global fand heraus, dass 42 % der Unternehmen 2025 die meisten ihrer KI-Initiativen aufgaben.
Wie überwacht man einen KI-Agenten in der Produktion?
Tracken Sie jeden Lauf, einschließlich Tool-Aufrufe und Retrievals, und verfolgen Sie Prompt-Änderungen gegen Ergebnisse. Tools wie Langfuse zusammen mit internen Dashboards machen Agenten-Entscheidungen nachvollziehbar.
Sollten wir einen KI-Agenten intern bauen oder mit einem Partner arbeiten?
Die NANDA-Forschung des MIT berichtet, dass von spezialisierten Anbietern gekaufte Lösungen deutlich häufiger erfolgreich sind als interne Eigenbauten. Bauen Sie intern, wenn der Workflow zum Kerngeschäft gehört und Sie Observability und Iteration personell stemmen können.