
Tekunda Team
Tekunda Team
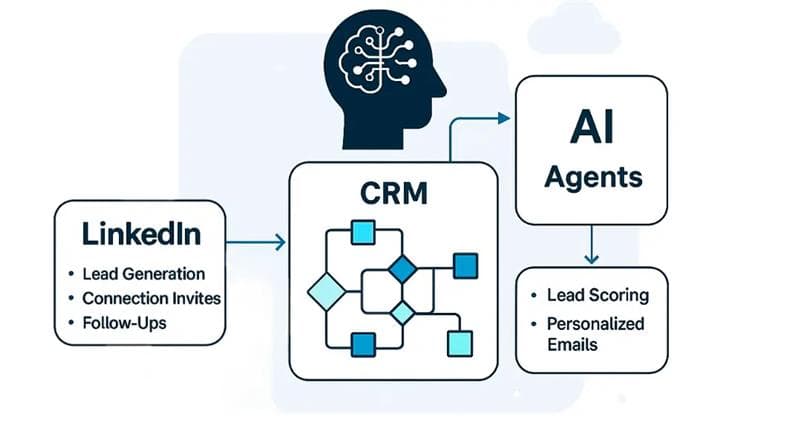
Réponse courte : un agent IA échoue en production à cause du système qui l'entoure, pas du modèle lui-même. Les causes habituelles : un périmètre pensé pour la démo, aucune intégration réelle avec les systèmes de référence, un contexte générique, des échecs silencieux que personne ne peut tracer, aucune boucle de feedback, et personne pour porter le résultat ou le coût. Nous avons rencontré la plupart de ces pièges en construisant notre propre agent de prospection outbound. Voici comment diagnostiquer le vôtre, et ce que nous avons changé pour que le nôtre tienne la route.
Le taux d'échec n'est pas anecdotique. Gartner prévoit que plus de 40 % des projets d'IA agentique seront abandonnés avant fin 2027, citant des coûts qui dérapent, une valeur business floue et des contrôles de risque insuffisants. S&P Global Market Intelligence a constaté que 42 % des entreprises ont abandonné la plupart de leurs initiatives IA en 2025, contre 17 % l'année précédente, et que 46 % des preuves de concept ont été écartées avant la production. Les travaux NANDA du MIT situent le problème de fond dans l'intégration et l'apprentissage, pas dans la qualité du modèle. Nous détaillons le tableau d'ensemble dans les agents IA en 2026 : ce qui marche vraiment et pourquoi la plupart des projets se sont enlisés.
D'après notre expérience, ces chiffres se décomposent en six modes d'échec :
Faites correspondre le symptôme à la cause avant de changer le modèle ou le prompt :
Chez Tekunda, nous voulions plus qu'une démo de salle de réunion : un agent qui automatise la prospection outbound sur LinkedIn et Salesforce, raisonne sur un contexte réel et décroche des appels. Chaque étape ci-dessous existe parce qu'un des modes d'échec ci-dessus nous a touchés en premier.
L'agent possède un seul workflow : d'une liste de leads LinkedIn à un appel décroché. Un résultat de recherche ou une liste Sales Navigator part dans Linked Helper, qui automatise les invitations de connexion dans les limites hebdomadaires de LinkedIn, les relances de remerciement et la synchronisation vers Salesforce. Une fois qu'une nouvelle connexion arrive dans le CRM, l'agent prend le relais.
L'agent raisonne sur les données de leads passées, dont l'historique de conversion, les critères de succès et les traits de segment, comme contexte de recherche documentaire. Nous avons testé des vector stores et une recherche documentaire basée sur PostgreSQL, et choisi selon les performances et le coût, avec un découpage et une récupération réglés pour la qualification de leads plutôt que pour une recherche générique.
La logique tourne dans Langflow, adossée à des flux Python sur mesure et à nos serveurs MCP internes qui gèrent les appels d'API, l'enrichissement et l'exécution des prompts. Le flux est stateless et découpé en petits micro-flux que nous réutilisons entre campagnes. Quand un agent devient plusieurs, les passations de relais deviennent le prochain point de rupture, c'est pourquoi nous avons écrit ce qui fait fonctionner les passations agent-à-agent en production.
Pour les leads qualifiés, l'agent rédige un email personnalisé à partir des informations de l'entreprise, des signaux de poste et de l'activité récente, avec un appel à l'action modelé sur ce qui a marché lors de gains précédents. Chaque email est renvoyé dans Salesforce, pour que les commerciaux voient la même fiche sur laquelle l'agent a agi.
Nous traçons chaque sortie de l'agent dans Langfuse et des tableaux de bord internes, avec une gestion d'erreurs structurée, un diff des prompts et une analyse des résultats intégrés au flux. Les signaux de conversion reviennent nourrir les couches de ranking et de prompt, et chaque semaine nous affinons les prompts, réentraînons les embeddings et ajustons le scoring. Cette boucle fait la différence entre un agent qui se dégrade et un agent qui s'améliore.
Le résultat : aucune passation manuelle de l'invitation à l'appel décroché. LinkedIn plafonne le haut de l'entonnoir, mais l'enrichissement, le scoring et la génération d'emails derrière montent en charge avec le pipeline.
Si votre agent vit dans Salesforce, décidez tôt s'il faut configurer ou construire : notre guide Agentforce contre agents IA sur mesure détaille cet arbitrage. Et si vous voulez un agent comme celui-ci construit autour de votre propre workflow, voyez comment nous construisons des agents IA en production ou parlez à notre équipe.
Pourquoi mes agents IA fonctionnent-ils en test mais échouent en production ?
Les tests tournent en général sur des données propres et un seul scénario idéal. La production ajoute des données sales, de vraies intégrations et des cas particuliers, et sans traçabilité ces échecs restent silencieux.
Combien de projets d'agents IA échouent ?
Gartner prévoit que plus de 40 % des projets d'IA agentique seront abandonnés avant fin 2027, et S&P Global a constaté que 42 % des entreprises ont abandonné la plupart de leurs initiatives IA en 2025.
Comment surveiller un agent IA en production ?
Tracez chaque exécution, y compris les appels d'outils et les recherches, et suivez les changements de prompt face aux résultats. Des outils comme Langfuse associés à des tableaux de bord internes rendent les décisions de l'agent déboguables.
Faut-il construire un agent IA en interne ou avec un partenaire ?
Les travaux NANDA du MIT rapportent que les solutions achetées à des fournisseurs spécialisés réussissent bien plus souvent que les constructions internes. Construisez en interne quand le workflow est stratégique et que vous pouvez staffer l'observabilité et l'itération.