
Tekunda Team

Tekunda Team
الجواب المختصر: يفشل وكلاء الذكاء الاصطناعي في الإنتاج عادة بسبب النظام المحيط بالنموذج، لا النموذج نفسه. الأسباب المعتادة هي نطاق مصمم للعرض التجريبي فقط، وغياب تكامل حقيقي مع أنظمة السجل الأساسية، وسياق عام، وأعطال صامتة لا يستطيع أحد تتبعها، وغياب حلقة تغذية راجعة، وعدم وجود مسؤول عن النتيجة أو التكلفة. واجهنا معظم هذه المشاكل أثناء بناء وكيلنا الخاص للتنقيب الصادر عن العملاء المحتملين. في ما يلي كيفية تشخيص وكيلك، وما غيّرناه لنجعل وكيلنا يصمد.
معدل الفشل ليس حكاية عابرة. تتوقع Gartner أن أكثر من 40% من مشاريع الذكاء الاصطناعي الوكيلي ستُلغى بنهاية 2027، مستشهدة بتصاعد التكاليف وغموض القيمة التجارية وضعف ضوابط المخاطر. ووجدت S&P Global Market Intelligence أن 42% من الشركات تخلّت عن معظم مبادراتها في الذكاء الاصطناعي خلال 2025، ارتفاعًا من 17% في العام السابق، وأن المؤسسات تخلّت عن 46% من النماذج الأولية قبل الوصول إلى الإنتاج. وحدد بحث NANDA في MIT المشكلة الجوهرية في التكامل والتعلّم، لا في جودة النموذج. نغطي الصورة الأوسع في وكلاء الذكاء الاصطناعي في 2026: ما ينجح فعلًا ولماذا تعثرت معظم المحاولات.
في تجربتنا، تتحلل هذه الأرقام إلى ستة أنماط فشل:
طابق العارض بالسبب قبل أن تغيّر النموذج أو الـ prompt:
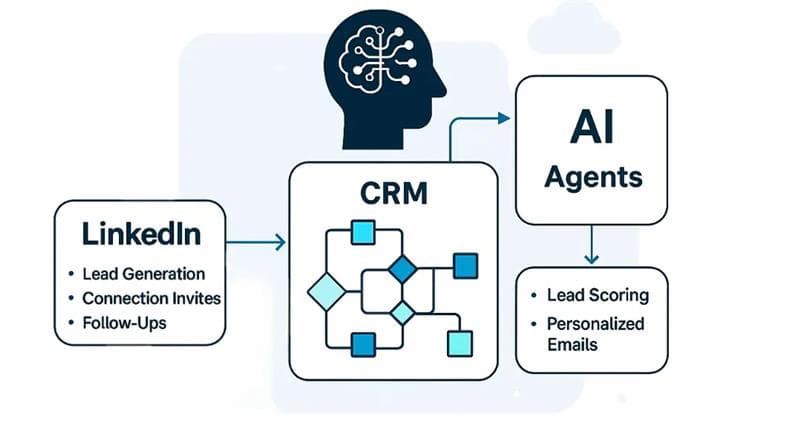
في Tekunda، كنا نريد أكثر من عرض تجريبي في غرفة اجتماعات: وكيلًا يُؤتمت التنقيب الصادر عبر LinkedIn و Salesforce، ويُفكّر وفق سياق حقيقي، ويحجز مكالمات. كل خطوة أدناه موجودة لأن أحد أنماط الفشل أعلاه أصابنا أولًا.
يملك الوكيل سير عمل واحد: من قائمة عملاء محتملين على LinkedIn إلى مكالمة محجوزة. تذهب نتيجة بحث أو قائمة Sales Navigator إلى Linked Helper، الذي يُؤتمت دعوات الاتصال ضمن حدود LinkedIn الأسبوعية، ورسائل الشكر اللاحقة، والمزامنة مع Salesforce. بمجرد أن يصل اتصال جديد إلى CRM، يتولّى الوكيل المهمة.
يُفكّر الوكيل في بيانات العملاء المحتملين السابقة، بما فيها تاريخ التحويل، ومعايير النجاح، وخصائص الشرائح، كسياق استرجاع. اختبرنا كلًا من قواعد المتجهات والاسترجاع المبني على PostgreSQL واخترنا بناءً على الأداء والتكلفة، مع تقسيم واسترجاع مضبوطين لتأهيل العملاء المحتملين لا للبحث العام.
يعمل المنطق في Langflow، مدعومًا بتدفقات Python مخصصة وخوادم MCP الداخلية لدينا التي تتعامل مع استدعاءات API والإغناء وتنفيذ الـ prompts. التدفق عديم الحالة ومُقسّم إلى تدفقات صغيرة نعيد استخدامها عبر الحملات. وعندما يتحوّل وكيل واحد إلى عدة وكلاء، تصبح عمليات التسليم بينهم نقطة الفشل التالية، لذلك كتبنا عن ما يجعل عمليات التسليم بين الوكلاء تعمل في الإنتاج.
بالنسبة للعملاء المحتملين المؤهلين، يصيغ الوكيل بريدًا إلكترونيًا شخصيًا من معلومات الشركة وإشارات الدور والنشاط الأخير، مع دعوة إلى اتخاذ إجراء مصاغة على غرار ما نجح في صفقات سابقة. يُعاد دفع كل بريد إلى Salesforce، فيرى فريق المبيعات نفس السجل الذي تصرّف الوكيل بناءً عليه.
نتتبع كل مخرجات الوكيل في Langfuse ولوحات التحكم الداخلية، مع معالجة أخطاء منظمة ومقارنة لإصدارات الـ prompt وتحليل للنتائج مدمجة في التدفق. تُغذّي إشارات التحويل طبقتي الترتيب والـ prompt من جديد، وكل أسبوع نُحسّن الـ prompts ونعيد تدريب embeddings ونضبط التقييم. هذه الحلقة هي الفرق بين وكيل يتراجع ووكيل يتحسّن.
النتيجة: لا تسليم يدوي من الدعوة إلى المكالمة المحجوزة. يحدّ LinkedIn من أعلى القمع، لكن الإغناء والتقييم وتوليد البريد خلفه يتوسعان مع خط الأنابيب.
إذا كان وكيلك يعيش داخل Salesforce، فحدد مبكرًا بين التهيئة والبناء: يشرح دليلنا Agentforce في مقابل وكلاء الذكاء الاصطناعي المخصصين هذا القرار. وإذا أردت وكيلًا كهذا مبنيًا حول سير عملك الخاص، راجع كيف نبني وكلاء ذكاء اصطناعي للإنتاج أو تواصل مع فريقنا.
لماذا تعمل وكلاء الذكاء الاصطناعي لدي في الاختبار وتفشل في الإنتاج؟
يعمل الاختبار عادة على بيانات نظيفة ومسار واحد مثالي. يضيف الإنتاج سجلات فوضوية وتكاملات حقيقية وحالات استثنائية، وبدون تتبّع تبقى هذه الأعطال صامتة.
كم عدد مشاريع وكلاء الذكاء الاصطناعي التي تفشل؟
تتوقع Gartner أن أكثر من 40% من مشاريع الذكاء الاصطناعي الوكيلي ستُلغى بنهاية 2027، ووجدت S&P Global أن 42% من الشركات تخلّت عن معظم مبادراتها في الذكاء الاصطناعي خلال 2025.
كيف تراقب وكيل ذكاء اصطناعي في الإنتاج؟
تتبّع كل تشغيل، بما فيه استدعاءات الأدوات والاسترجاعات، وتابع تغييرات الـ prompt في مقابل النتائج. أدوات مثل Langfuse إلى جانب لوحات التحكم الداخلية تجعل قرارات الوكيل قابلة لتصحيح الأخطاء.
هل يجب أن نبني وكيل ذكاء اصطناعي داخليًا أم مع شريك؟
أفاد بحث NANDA في MIT أن الحلول المشتراة من موردين متخصصين تنجح أكثر بكثير من عمليات البناء الداخلية. ابنِ داخليًا عندما يكون سير العمل جزءًا جوهريًا من عملك وتستطيع تدبير الرصد والتكرار.